Introdução
Eu costumava aceitar o que a regressão logística (ou qualquer modelo de predição) entregava: um score — digamos, 23% de probabilidade de alguma coisa — e isso orientava minhas decisões. Só que esses números mágicos escondem histórias inteiras. Dois clientes podem carregar o mesmo score e, ainda assim, pertencer a mundos completamente distintos.
E se dois clientes idênticos para o modelo frequentista fossem, na prática, riscos opostos para o negócio?
Na estatística frequentista, tratamos parâmetros como valores fixos, mas desconhecidos, estimados por máxima verossimilhança. O resultado é uma estimativa pontual, por exemplo: β₁ = 0,42, β₂ = −0,15. Na inferência bayesiana, parâmetros são variáveis aleatórias com distribuições de probabilidade. Onde o frequentista enxerga um número fixo, o bayesiano enxerga uma distribuição inteira.
Considere dois clientes com probabilidades idênticas de 20% de alguma coisa. No mundo frequentista, eles são indistinguíveis. No mundo bayesiano, o primeiro pode ter uma distribuição preditiva concentrada em torno de 20% ± 2%, enquanto o segundo varia entre 5% e 35%. Essa diferença de dispersão não é detalhe — é risco adicional que deveria influenciar diretamente nossa decisão.
Escolhi o dataset UCI Credit Card Default para este estudo de caso. Dados de crédito apresentam naturalmente alta variabilidade e incerteza, ideais para explorar a modelagem bayesiana. Em vez de ignorar regiões pouco exploradas do espaço de features, a abordagem bayesiana as quantifica explicitamente, permitindo estratégias de decisão mais sofisticadas: ser mais conservador em cenários de alta incerteza ou investir em coleta de dados para reduzi-la.
A sequência vai ser simples: mostro um modelo clássico como baseline, construo o equivalente bayesiano e comparo os resultados em cenários de tomada de decisão. A questão não é se nossos modelos têm incerteza — eles sempre têm. A questão é se escolhemos reconhecê-la e usá-la a nosso favor.
Introduzindo o Dataset
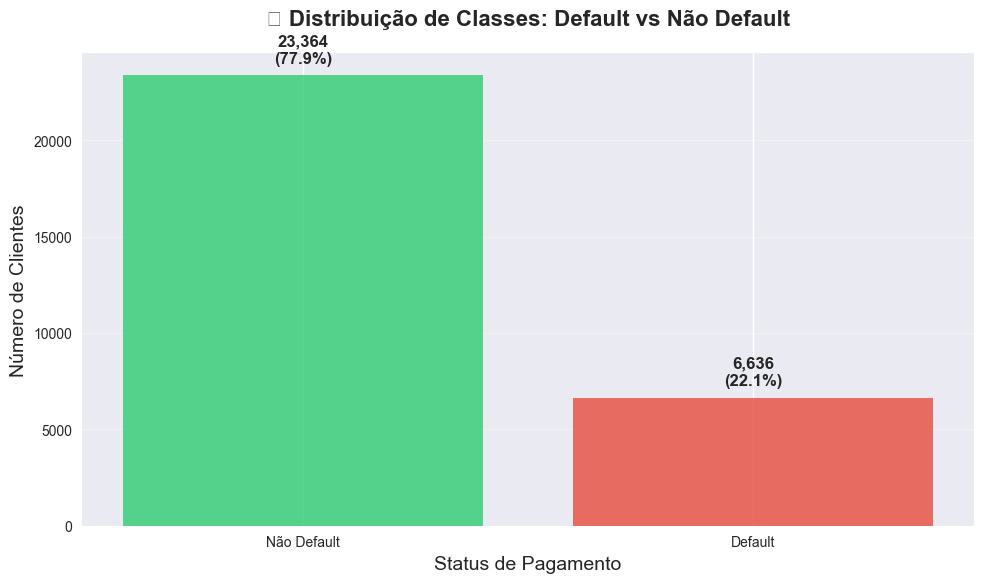
O dataset UCI Credit Card Default tem 30.000 registros completos, sem dados faltantes. Escolhi usar apenas duas features (limite de crédito e idade) para reduzir a complexidade e focar nas diferenças entre abordagens. Nesse dataset, o target é 77.9% de não-defaulters versus 22.1% de defaulters — um desbalanceamento moderado.
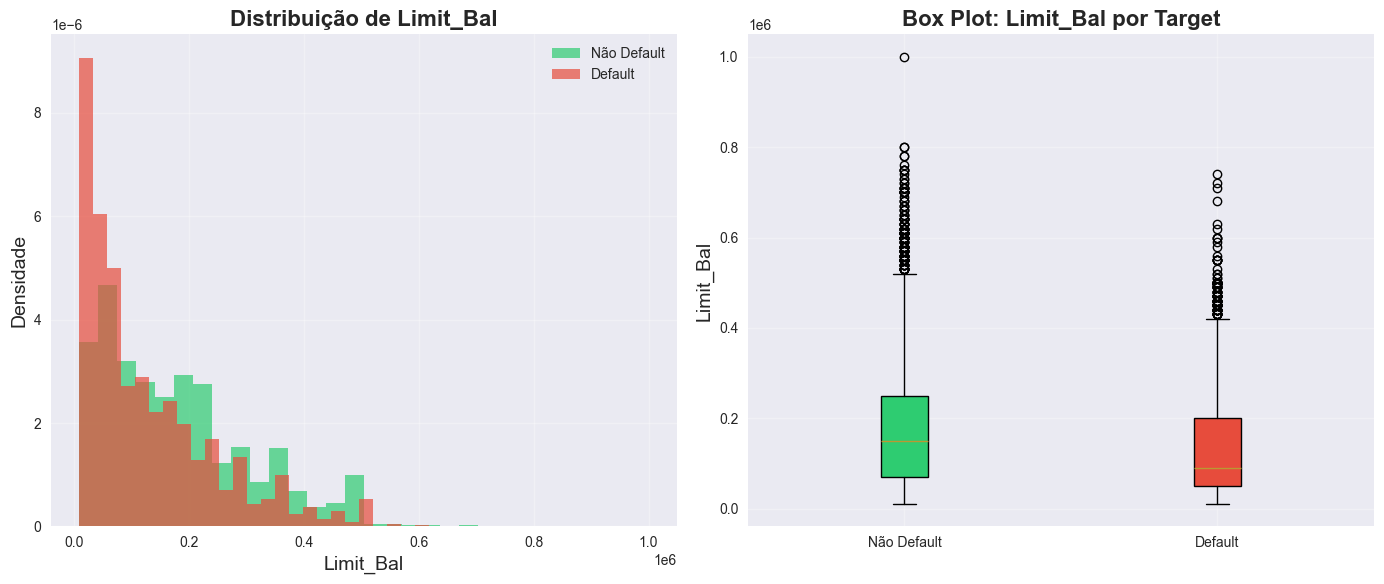
O limite de crédito mostra que clientes sem default têm limite médio de R$ 178.100 versus R$ 130.110 para clientes com default — uma diferença de 26.9% que sugere poder discriminativo forte, mas com sobreposição considerável nas distribuições.
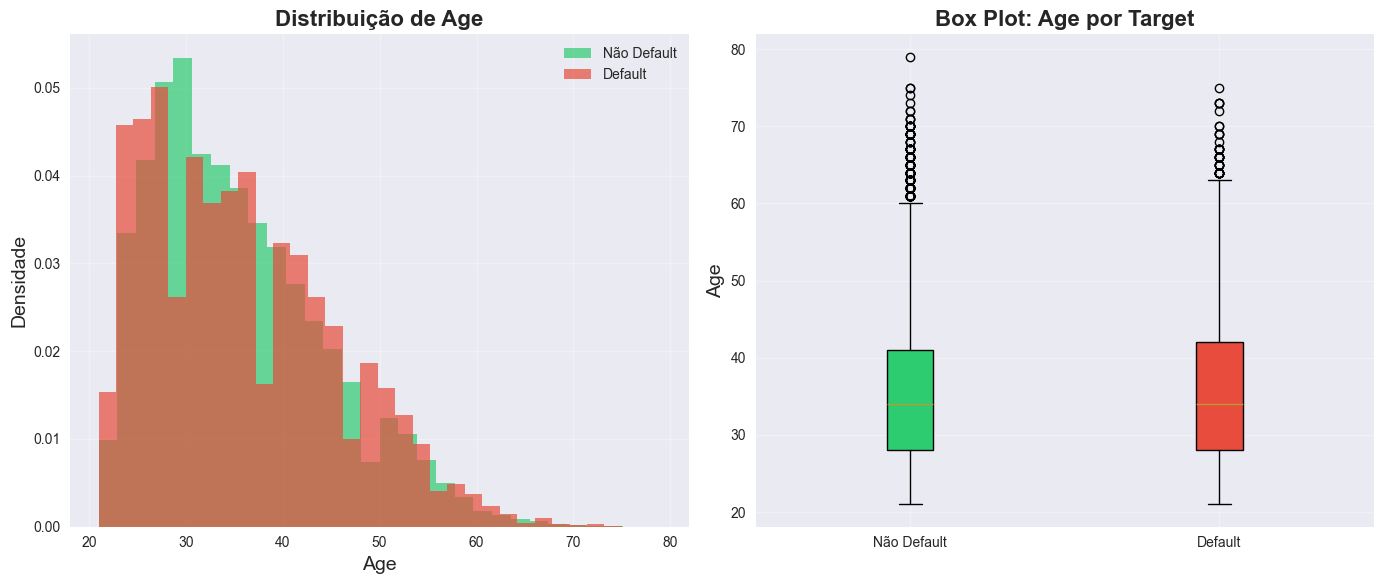
A idade, por outro lado, apresenta diferença mínima (0.9%) entre grupos, sugerindo que o coeficiente Bayesiano correspondente terá alta incerteza — precisamente o tipo de insight que estimativas pontuais mascaram.
O próximo passo é implementar ambas as abordagens e quantificar como a informação adicional da inferência Bayesiana pode transformar decisões de crédito.
Modelo Frequentista: A Abordagem Clássica
Comecei pela implementação frequentista porque ela representa o paradigma dominante em modelagem de crédito. A maioria dos sistemas de credit scoring se baseiam nesta abordagem — estimativas pontuais, intervalos de confiança, e a premissa de que existe um “valor verdadeiro” dos parâmetros a ser descoberto.
É o paradigma dominante. Mas será que ainda é suficiente?
Segui o protocolo padrão de ML para preparar os dados: normalização e divisão estratificada para manter a proporção de defaults em treino e teste.
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
import statsmodels.api as sm

# Preparação dos dados
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# Modelo frequentista com statsmodels
X_train_sm = sm.add_constant(X_train_scaled)
logit_model = sm.Logit(y_train, X_train_sm)
frequentist_result = logit_model.fit()
Eu prefiro o statsmodels em vez do sklearn porque gosto dos intervalos de confiança e testes de significância. O sklearn é otimizado para predição; o statsmodels para inferência.
Na imagem abaixo, os coeficientes estimados representam o log-odds ratio para cada feature. Um coeficiente β₁ = -0.4683 significa que um aumento de um desvio padrão na feature correspondente diminui as chances de default por um fator de exp(-0.4683) ≈ 0.626. Em termos práticos: essa variável reduz o risco em cerca de 60%.
 imagem não recuperada
Mas aqui está o ponto crítico: o modelo frequentista me dá β₁ = -0.47 ± 0,0368 (intervalo de confiança de 95%). Isso significa que, se repetíssemos o experimento infinitas vezes, 95% dos intervalos calculados conteriam o “valor verdadeiro” do parâmetro. Note a sutileza: não posso dizer que há 95% de probabilidade do parâmetro estar neste intervalo — isso seria interpretação Bayesiana de um resultado frequentista.
O teste de significância estatística (p-valores) adiciona outra camada de informação. Variáveis com p > 0.05 são tradicionalmente consideradas “não significativas”, mas esta interpretação binária esconde nuances importantes. Um p-valor de 0.06 versus 0.60 conta histórias muito diferentes sobre a evidência contra a hipótese nula.
O Modelo Bayesiano: Distribuições Completas
A transição para o bayesiano exige uma mudança na forma como pensamos sobre incerteza. Enquanto o modelo frequentista fornece estimativas pontuais dos coeficientes, agora precisamos especificar distribuições completas — tanto para o conhecimento inicial quanto para as inferências finais. Isso demanda mais trabalho no início. É tentador deixar o modelo “resolver tudo sozinho” apenas com os dados, mas é justamente na etapa de modelar explicitamente o que sabemos (e o que não sabemos) que está a força da abordagem.
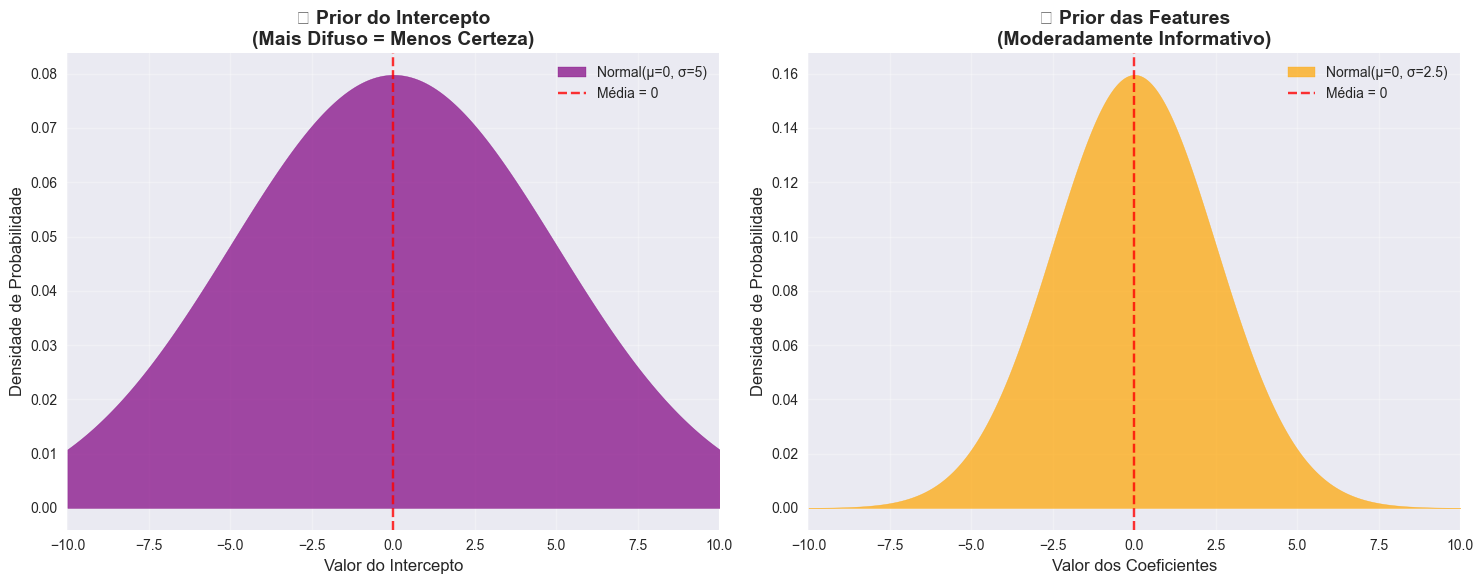
Comecei definindo os priors, que representam meu conhecimento inicial sobre os parâmetros antes de observar os dados. A escolha dos priors deve refletir conhecimento genuíno sem dominar excessivamente a evidência empírica.
# Prior para o intercepto (mais difuso - menos certeza)
beta_intercept = pm.Normal("beta_intercept", mu=0.0, sigma=5.0)

# Priors para os coeficientes das features (moderadamente informativos)
beta_features = pm.Normal("beta_features", mu=0.0, sigma=2.5,
                         shape=n_features-1)
Para o intercepto, utilizei uma distribuição Normal(0, 5) — um prior relativamente difuso que expressa baixa certeza sobre o valor base do log-odds. Para os coeficientes das features, optei por Normal(0, 2.5), priors moderadamente informativos que favorecem efeitos próximos a zero mas permitem valores substanciais se os dados justificarem.
A construção da likelihood seguiu a mesma estrutura da regressão logística frequentista, mas agora cada parâmetro β é uma variável aleatória com sua própria distribuição. O modelo combina os priors com a likelihood através da regra de Bayes, produzindo distribuições posteriores que representam nosso conhecimento atualizado após observar os dados. Configurei a amostragem — 1.000 amostras após 1.000 iterações de aquecimento.
idata = pm.sample(
    draws=n_draws,
    tune=n_tune,
    chains=n_chains,
    cores=1,
    target_accept=0.9,
    random_seed=42,
    progressbar=False,
    return_inferencedata=True,
    discard_tuned_samples=True
)
As distribuições posteriores dos coeficientes capturam algo que o modelo frequentista não consegue expressar: a incerteza completa sobre cada parâmetro da regressão. Cada coeficiente agora é uma distribuição completa, não um valor pontual. Esta representação permite quantificar precisamente o quanto sabemos sobre cada efeito e propagar essa incerteza para as predições finais.
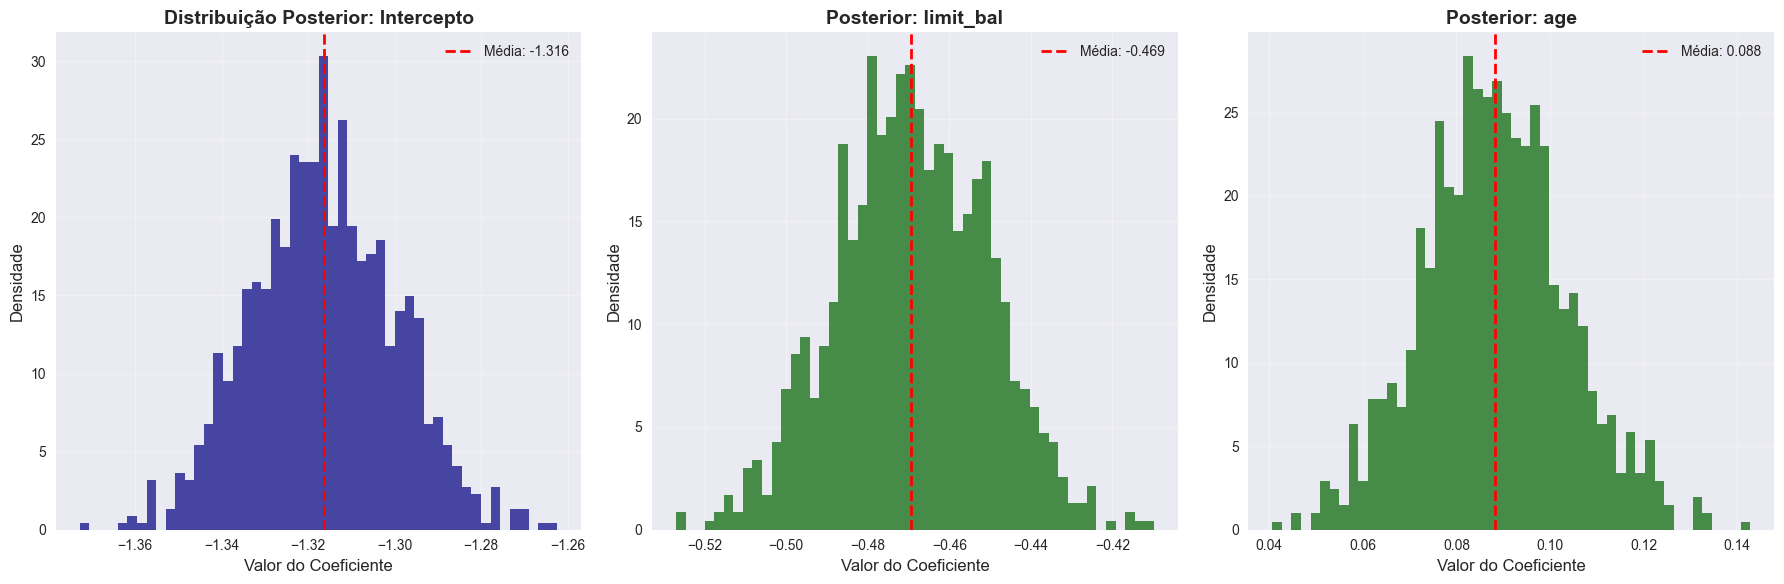
É possível observar não apenas as médias dos coeficientes, mas suas dispersões, assimetrias, e toda a estrutura probabilística. Esta informação se torna muito útil quando preciso tomar decisões sob incerteza — especialmente em contextos financeiros onde o custo de uma decisão errada pode ser expressivo.
O modelo bayesiano está pronto para gerar predições. Diferentemente do modelo frequentista que produz scores pontuais, as predições bayesianas incluirão intervalos de credibilidade que quantificam explicitamente a incerteza associada a cada decisão.
Comparação: Quando os Números se Encontram
Uma comparação entre os coeficientes frequentistas e bayesianos vai te revelar valores centrais similares — mas com interpretações fundamentalmente diferentes sobre o que esses números significam.
O intercepto frequentista de -1.3165 versus o bayesiano de -1.3164 representam uma diferença de 0%. O coeficiente do limite de crédito mostrou -0.4683 versus -0.4693 (diferença de 0.2%), e a idade 0.0881 versus 0.0882 (diferença de 0.1%). Os modelos são iguais.
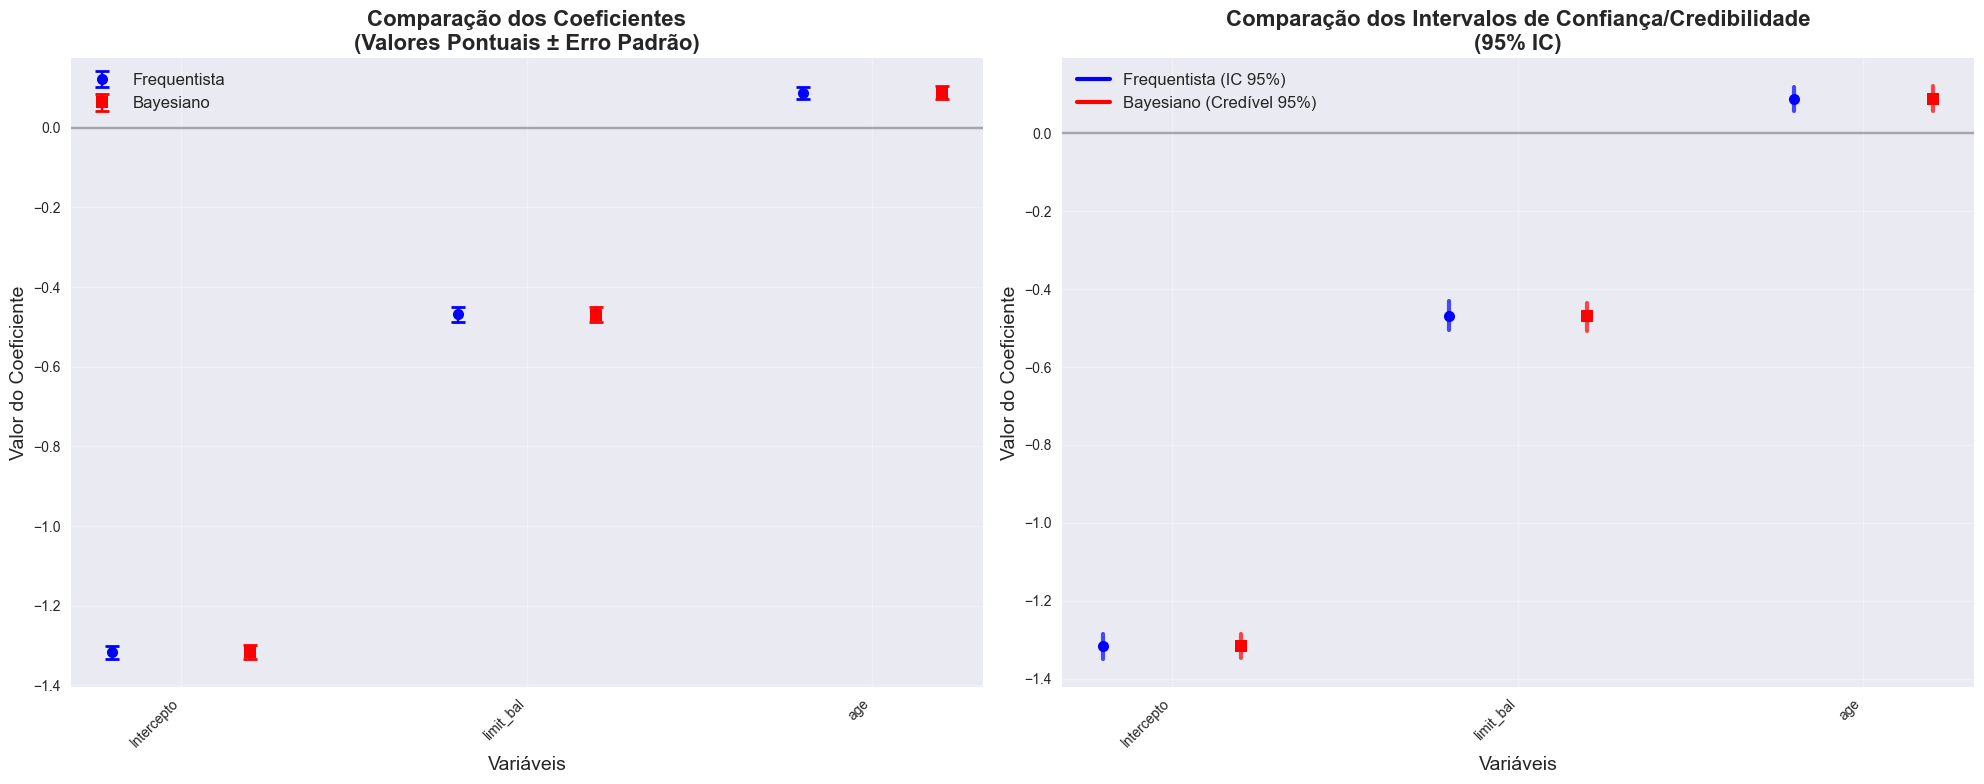
Mas aqui está o ponto: essa convergência numérica esconde uma diferença conceitual. Quando o modelo frequentista me fornece um intervalo de confiança de 95%, ele está fazendo uma afirmação sobre o procedimento estatístico — se eu repetisse este experimento infinitas vezes, 95% dos intervalos construídos conteriam o verdadeiro parâmetro. É uma propriedade da metodologia, não uma probabilidade sobre o parâmetro específico.
O intervalo de credibilidade bayesiano, por outro lado, expressa diretamente minha crença sobre onde o parâmetro provavelmente está. Quando vejo que o coeficiente do limite de crédito tem 95% de probabilidade de estar entre -0.5062 e -0.4342, isso é uma afirmação direta sobre o parâmetro.
Os valores centrais são praticamente idênticos, mas as barras de erro carregam significados diferentes. No contexto de decisões de crédito, por exemplo, essa distinção importa: posso usar o intervalo bayesiano para quantificar diretamente minha incerteza sobre o impacto de cada variável no risco de inadimplência.
Tomando Decisões com Incerteza Quantificada
Para cada cliente, calculei 1.000 predições diferentes — uma para cada amostra dos coeficientes da distribuição posterior. Isso resulta em matrizes de forma (24000, 1000) para treino e (6000, 1000) para teste, onde cada linha representa um cliente e cada coluna uma predição baseada em uma amostra diferente dos parâmetros.
# Predições para cada amostra da posterior (distribuição completa)
logits_train_samples = X_train_bayes @ beta_samples_all.T
logits_test_samples = X_test_bayes @ beta_samples_all.T

p_train_samples = 1 / (1 + np.exp(-logits_train_samples))
p_test_samples = 1 / (1 + np.exp(-logits_test_samples))

# Estatísticas das predições Bayesianas
p_pred_train_bayes = p_train_samples.mean(axis=1)
p_pred_test_bayes = p_test_samples.mean(axis=1)
p_train_std = p_train_samples.std(axis=1)
p_test_std = p_test_samples.std(axis=1)
A performance pontual, como esperado, permanece praticamente idêntica entre os dois paradigmas — AUC de 0.5948 para ambos. Mas agora possuímos uma outra dimensão: a quantidade de incerteza para cada predição. O desvio padrão das 1.000 predições por cliente varia entre 0.0028 e 0.0153, com média de 0.0044.
A correlação entre probabilidade predita e incerteza é de 0.6008, indicando que predições em regiões de maior risco tendem a ter maior variabilidade. Isso faz sentido intuitivo: clientes próximos à fronteira de decisão naturalmente apresentam maior incerteza na classificação.
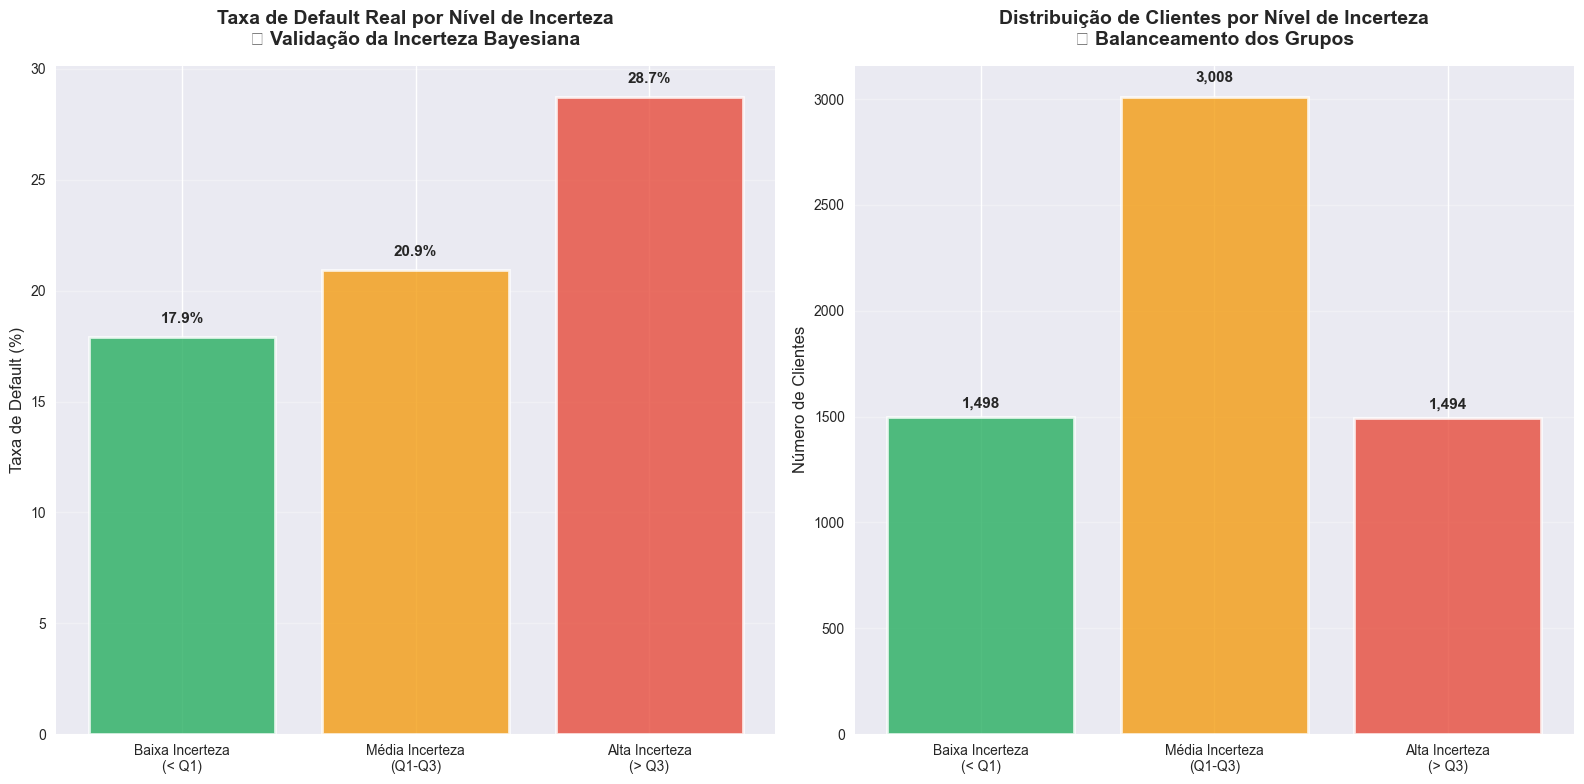
Segmentei os clientes em grupos baseados na incerteza. Utilizando quartis como limiares, criei três categorias: baixa incerteza (< 0.0035), média incerteza (0.0035-0.0050), e alta incerteza (> 0.0050). Os resultados confirmam que clientes com maior incerteza apresentam taxa de default significativamente superior.
Clientes no grupo de baixa incerteza apresentam taxa de default de 17.9%, enquanto aqueles com alta incerteza atingem 28.7% — uma diferença de 10.8 pontos percentuais. Essa segmentação oferece uma dimensão adicional para estratégias de negócio: clientes com predições similares podem requerer tratamentos diferentes baseados na confiança do modelo.
O gráfico abaixo, de dispersão probabilidade versus incerteza, ilustra essa complexidade. Dois clientes com probabilidade de default de 25% podem ter incertezas drasticamente diferentes — um com desvio padrão de 0.003 e outro com 0.010. O primeiro representa uma predição confiável; o segundo sugere cautela adicional na tomada de decisão.
Regiões centrais de probabilidade (~20%) apresentam baixa incerteza, refletindo áreas bem amparadas pelos dados de treino. Extremidades da escala (acima de 30% e abaixo de 10%) exibem incertezas crescentes, indicando perfis menos frequentes ou com características mais raras.
A linha tracejada laranja marca o 75º percentil de incerteza. Clientes acima dessa linha — independentemente da probabilidade média — representam casos onde a dispersão das predições é alta, e portanto a confiança no score é menor.
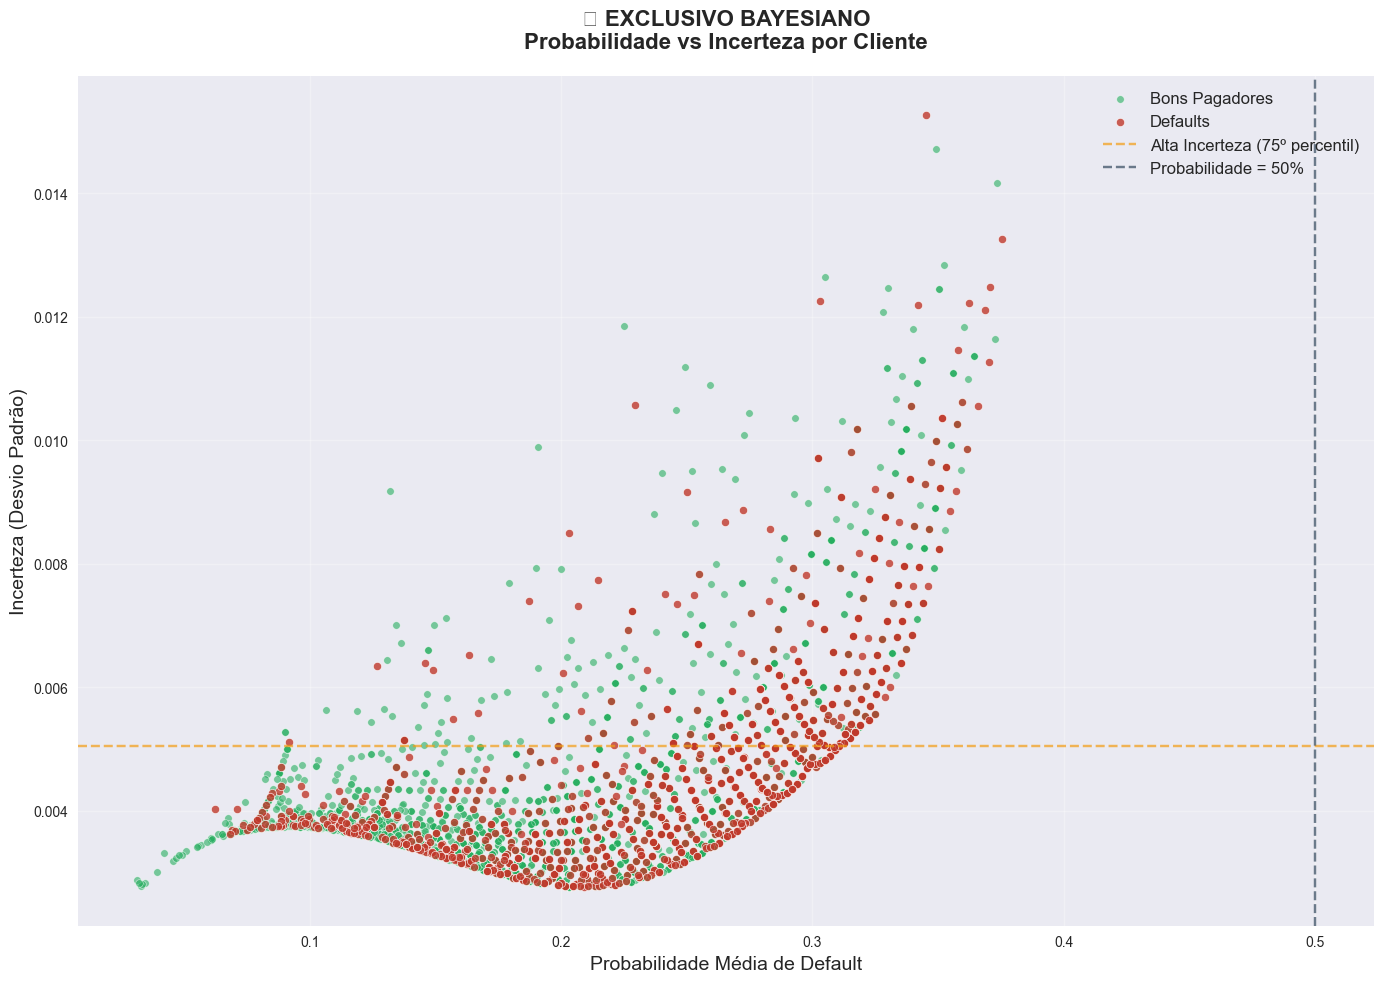
Quantificar a incerteza transforma como interpretamos predições de modelos. Não se trata apenas de saber se um cliente vai ter uma probabilidade, mas de compreender quão confiante o modelo está nessa predição.
Transformando Incerteza em Valor: O Sistema de Três Vias
A quantificação de incerteza só ganha significado quando se traduz em decisões melhores. Adotei um sistema simples que explora essa premissa, comparando a abordagem frequentista tradicional com um framework bayesiano de três vias que transforma incerteza em uma categoria de decisão explícita.
Comecei definindo os parâmetros de negócio que simulam alguma realidade financeira de crédito: aprovar um cliente que dará default custa R$ 600, aprovar um bom cliente gera R$ 200 de lucro, e não aprovar um cliente representa um custo de oportunidade de R$ 50. A partir desses valores, calculei o threshold teórico ótimo usando a fórmula de decisão bayesiana, que resultou em 0.294.
def calculate_optimal_threshold(C_def, G, C_perda):
    return (G + abs(C_perda)) / (abs(C_def) + G + abs(C_perda))

tau_star = calculate_optimal_threshold(-C_APROVA_DEFAULT, G_APROVA_BOM, -C_NAO_APROVA)
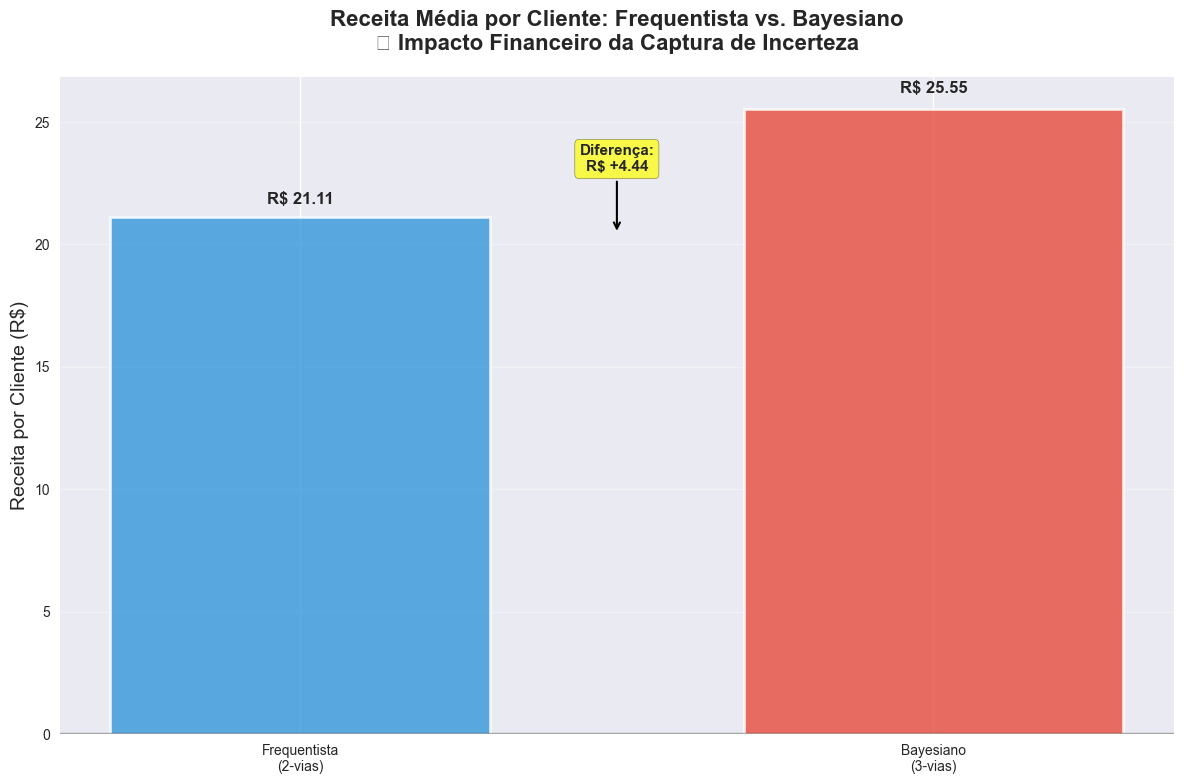
O sistema frequentista opera no paradigma binário tradicional: aprovar ou recusar. Aplicando o threshold de 0.294, obtive uma distribuição de 84.3% de aprovações contra 15.7% de recusas, gerando uma receita de R$ 21.11 por cliente. Essa abordagem trata todas as predições como igualmente confiáveis.
O sistema bayesiano introduz uma terceira categoria: revisar. Construí regras de decisão baseadas em intervalos de credibilidade de 90%, onde cada cliente recebe não apenas uma probabilidade pontual, mas um intervalo que quantifica nossa incerteza sobre essa predição.
p_lo = np.percentile(p_test_samples, q_lo * 100, axis=1)
p_hi = np.percentile(p_test_samples, q_hi * 100, axis=1)

decisions_bayes = np.where(
    p_hi < tau_star, "aprovar",
    np.where(p_lo > tau_star, "recusar", "revisar")
)
As regras são intuitivas: se o limite superior do intervalo está abaixo do threshold, aprovo com confiança; se o limite inferior está acima, recuso com confiança; se o intervalo cruza o threshold, marco para revisão manual. Essa lógica resultou em 78.2% aprovações, 11.4% recusas e 10.3% revisões.
Clientes aprovados têm probabilidade média de default de 0.197 com baixa incerteza (0.0039), confirmando que são casos claros. Clientes recusados apresentam probabilidade de 0.324 com incerteza ligeiramente maior (0.0070). O grupo de revisão, com probabilidade média de 0.293, situa-se exatamente na região de incerteza próxima ao threshold, com taxa de default real de 27.6%.
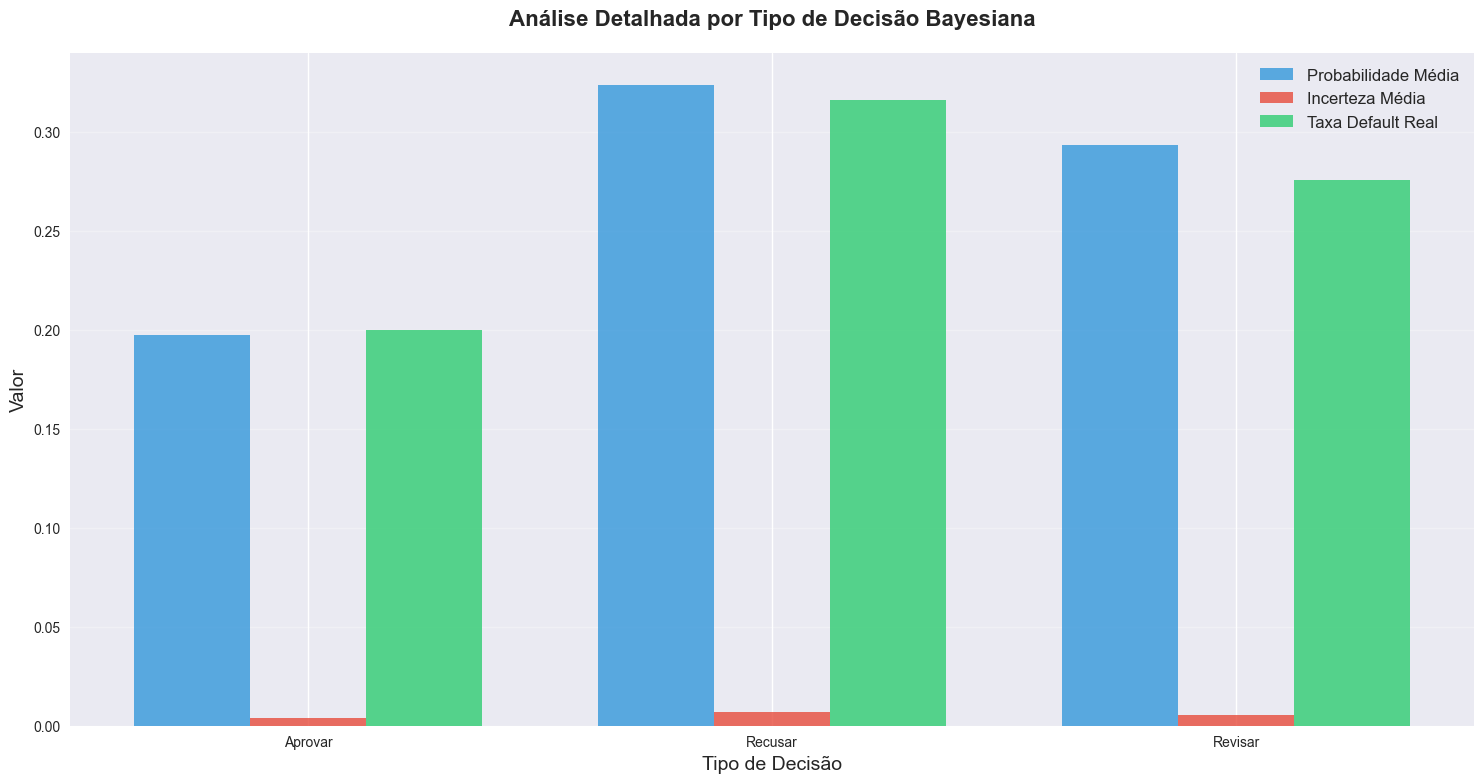
A categoria “revisar” captura os casos onde a incerteza do modelo é alta e a decisão automática seria questionável. Esses 620 clientes (10.3% da base) representam onde o investimento em análise humana ou compra de dados adicionais poderia gerar maior retorno, transformando incerteza estatística em oportunidade.
Essa abordagem de três vias identifica sistematicamente onde a expertise humana ou compra de dados adicionais adicionaria valor máximo, criando um sistema híbrido que otimiza tanto eficiência quanto precisão.
O Impacto Financeiro: ROI com Incerteza Quantificada
Quis traduzir toda essa teoria em números. Fiz uma função de cálculo de receita que considera as três categorias de decisão do modelo bayesiano e comparei diretamente com o resultado binário do modelo frequentista.
def calculate_revenue_threeway(decisions, y_true, costs):
    total_revenue = 0
    for i, decision in enumerate(decisions):
        if decision == "aprovar":
            if y_true[i] == 0:  # Bom cliente
                total_revenue += costs['gain_good']
            else:  # Default
                total_revenue += costs['cost_default']
        elif decision == "recusar":
            total_revenue += costs['cost_decline']
        # revisar tem custo zero (análise manual decide perfeitamente)
    return total_revenue
O resultado: R$ 153.300 para o modelo bayesiano contra R$ 126.650 do frequentista. Uma diferença de R$ 26.650, representando 21% de melhoria. O modelo frequentista gera R$ 21,11 por cliente, enquanto o bayesiano alcança R$ 25,55. A diferença de R$ 4,44 por cliente pode parecer pequena, mas se torna substancial quando projetada para um volume significativo.
A categoria “revisar” atua como uma válvula de escape para a incerteza do modelo. Casos com alta variância na distribuição posterior — aqueles onde o modelo “hesita” entre aprovar e recusar — são automaticamente flagged para revisão. Isso reduz tanto falsos positivos quanto falsos negativos nas decisões automatizadas.
A complexidade adicional do framework bayesiano se justifica não apenas pelos resultados financeiros, mas pela criação de um sistema mais robusto e interpretável. Esses números dependem, obviamente, de premissas específicas sobre custos e da eficácia do processo de revisão. Na prática, o valor real pode variar conforme a qualidade e os custos operacionais desse processo de três vias. Ainda assim, existe uma margem de melhoria que sugere que o sistema bayesiano manteria vantagem.
Conclusão: Incerteza Como Vantagem Competitiva
A superioridade da inferência bayesiana não reside na performance preditiva. Ambos os modelos apresentaram AUC idêntico de 0.5948. A diferença não está na capacidade de separar classes, mas na forma como processamos e utilizamos a incerteza.
Enquanto o modelo frequentista gerou R$ 21.11 por cliente, o bayesiano alcançou R$ 25.55 - uma vantagem de R$ 4.44 por cliente. Essa diferença vem da capacidade de quantificar incerteza e transformá-la em decisões mais granulares.
A capacidade de “saber que não sabe” representa uma mudança em como construímos sistemas de decisão. Não se trata apenas de otimizar métricas de classificação, mas de criar sistemas que reconhecem suas limitações e agem de acordo.
Estamos comparando paradigmas fundamentalmente diferentes. Em sistemas de crédito, a capacidade de identificar casos duvidosos permite alocar recursos adicionais onde são mais necessários. Em seguros, a quantificação de incerteza habilita precificação mais granular.
Reconheço as limitações desta abordagem. A complexidade computacional do MCMC, o tempo de treinamento superior e a curva de aprendizado mais íngreme representam barreiras para implementação.
O insight mais profundo desta análise é que modelos que “sabem que não sabem” são mais valiosos porque habilitam metacognição - a capacidade de raciocinar sobre o próprio raciocínio.
A inferência bayesiana nos força a abandonar a ilusão de certeza absoluta e abraçar a realidade probabilística do mundo. Neste contexto, a incerteza deixa de ser limitação para se tornar vantagem competitiva. Modelos que sabem que não sabem não são apenas mais estatísticos. São mais inteligentes
Se você curtiu esta análise e quer receber os próximos artigos, inscreva-se na minha newsletter 🙂